


PostgreSQL’i Okumak Değil, Anlamak – Config Dosyaları – postgresql.conf – Bölüm 2
Öncelikle merhabalar , sqlekibi.com’a hoş geldin.
Bu serimizde PostgreSQL içerisindeki hayati öneme sahip CONF dosyalarını önce temel inşa edip ardından detaya inecek şekilde kafanda netleştirme hedefiyle klavye başına geçmiş bulunuyorum.
3 büyük config dosyasını tek bir makalede ele alıp yüzeysel olarak geçmek yerine her bir config dosyasının içindeki kritik noktaları ayrı ayrı bölümler halinde ele alacağım.
Amacım içi boş ve sıkıcı bir yazı okuyarak vakit kaybetmen değil , bir meslektaşım olarak senin hayatına pozitif anlamda dokunabilmek olacak.
Konuya geçiyorum , önceki bölümü okumadıysan : https://www.kisa.link/IhbaL
postgresql.conf: Bellek Yönetimi (Resource Usage) ve Görünmeyen Tehlikeler
İlk bölümde PostgreSQL’in dış dünya ile nasıl konuştuğunu, kimleri içeri aldığını ve bağlantı tarafında yapılan hataların sistemi nasıl kilitleyebildiğini konuştuk.
Bu bölümde ise iş biraz daha sessiz ama çok daha tehlikeli bir alana giriyor: bellek yönetimi.
Şunu en baştan net söyleyeyim:
PostgreSQL’de performans problemlerinin büyük bir kısmı sorgudan değil, yanlış bellek varsayımlarından çıkar. Ve bu problemler genelde şöyle başlar:
“Sunucu güçlü aslında ama neden yine de yavaş?”
“CPU boş, disk hızlı ama bir şeyler yolunda değil.”
Cevap çoğu zaman bu başlık altında saklıdır.
PostgreSQL Belleği Nasıl Düşünür?
PostgreSQL belleği tek parça bir alan gibi düşünmez.
Benim yıllar içinde fark ettiğim en büyük hata da bu zaten:shared_buffers’ı artır, work_mem’i yükselt, “tamamdır” san.
Oysa PostgreSQL belleği kabaca üçe ayırır:
- Shared memory (herkesin ortak kullandığı alan)
- Per-backend memory (her bağlantıya özel)
- Geçici / operasyonel bellek (sort, hash, vacuum vs.)
Ve bu üç alanın birbirini çok kolay boğabildiği bir gerçek.
shared_buffers – PostgreSQL’in Hafızası (Ama Her Şeyi Değil)
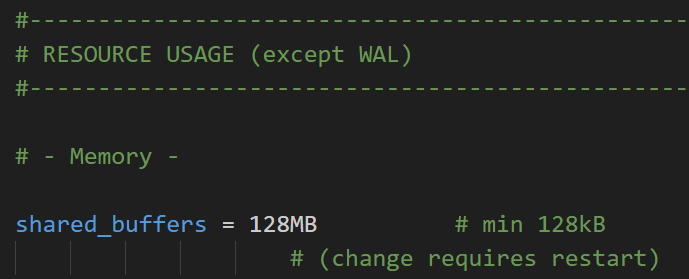
Bu parametre PostgreSQL dünyasında en çok konuşulan ama en çok da yanlış anlaşılan ayardır.
shared_buffers, PostgreSQL’in diskten okuduğu verileri kendi cache’inde tutmak için kullandığı alandır. Yani:
- Table data
- Index pages
burada yaşar.
Ama kritik nokta şu:
PostgreSQL, işletim sisteminin de cache mekanizmasına güvenir.
Yani “ne kadar çok verirsem o kadar iyi” mantığı burada çalışmaz.
Genel bir kural olarak:
- Çok düşük olursa: PostgreSQL diske fazla gider
- Çok yüksek olursa: OS cache boğulur, sistem genel performansı düşer
Ve evet, bu ayar restart gerektirir.
Canlı sistemde “deneyelim bakalım” diye oynanacak bir ayar değildir.
work_mem – En Masum Görünümlü Tehlike

Eğer PostgreSQL’de bir sistem çöktüyse ve ortada bariz bir sebep yoksa, ben genelde dönüp ilk buraya bakarım.
work_mem, bir sorgunun sort veya hash gibi işlemler için kullanabileceği bellek miktarıdır.
Ama kritik detay şurada:
Bu bellek sorgu başına, hatta bazı durumlarda birden fazla kez ayrılır.
Yani:
- 1 sorgu → 1 work_mem
değil. - 1 sorgu
- 2 join
- 1 sort
- 1 hash
→ birden fazla work_mem tüketimi olabilir.
Üstüne bir de:
- Yüksek
max_connections - Yoğun paralel sorgular
eklenirse, RAM’in nasıl buharlaştığını anlamazsın bile.
Bu yüzden work_mem:
- Küçük tutulur
- Gerekirse session bazlı artırılır
- Global olarak şişirilmez
maintenance_work_mem – Sessiz Ama Güçlü
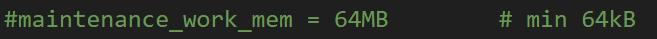
Bu ayar:
- VACUUM
- CREATE INDEX
- ALTER TABLE
- ANALYZE
gibi bakım işlemlerinde kullanılır.
Buradaki güzel nokta şu:
Bu bellek her sorgu için değil, bakım operasyonları için kullanılır.
Yani doğru ayarlandığında:
- Index creation hızlanır
- Autovacuum daha verimli çalışır
Ama burada da aşırıya kaçmak:
- Disk IO’yu patlatabilir
- Özellikle paralel maintenance varken sistemi zorlayabilir
autovacuum_work_mem

-1 demek:
maintenance_work_mem’i kullan
Bu genelde doğru bir tercih.
Ama autovacuum’un yoğun çalıştığı sistemlerde, burayı bilinçli olarak ayırmak fark yaratabilir.
Çünkü autovacuum:
- Sürekli çalışan
- Ama “arka planda” olduğu için fark edilmeyen
bir süreçtir.
temp_buffers – Görmezden Gelinen Performans Detayı

Temporary table kullanan uygulamalarda bu ayar önemlidir.
Ama çoğu sistemde:
- Default değeri yeterlidir
- Performans darboğazı buradan çıkmaz
Bu yüzden ben genelde:
“İhtiyacın olduğunu bilmiyorsan, dokunma”
kuralını uygularım.
Disk Tarafı – PostgreSQL Diske Ne Zaman ve Nasıl Yüklenir?
PostgreSQL’de disk tarafı genelde şu cümleyle geçiştirilir:
“Diskimiz hızlı, NVMe var.”
Ama sahada şunu çok net gördüm:
Diskin hızlı olması yetmiyor, PostgreSQL’in diski ne zaman ve nasıl kullandığını anlamazsan, o NVMe’yi bile ağlatabiliyorsun.
Dipnot | NVM (Non-Volatile Memory):
Elektrik kesildiğinde verisini kaybetmeyen, klasik disklerden çok daha düşük gecikme sürelerine sahip bellek tabanlı depolama teknolojilerinin genel adıdır.
NVMe diskler ve bazı modern storage çözümleri bu kategoriye girer. PostgreSQL açısından bakıldığında, bu tip depolama sistemleri paralel IO’dan çok daha fazla fayda sağlar.
temp_file_limit – Kontrolsüz Sorgulara Fren Mekanizması

PostgreSQL bir sorgu için ayırdığı bellek (work_mem) yetmezse ne yapar biliyor musun?
Sessizce diske yazar.
Ve bu dosyalar:
base/pgsql_tmp- ya da tablespace altlarında
oluşur.
temp_file_limit tam olarak şunu söyler:
“Bir backend, disk üzerinde en fazla ne kadar geçici dosya oluşturabilir?”
-1 demek:
“Sınır yok, ne kadar isterse yazsın.”
Gerçek hayatta bu ne demek?
- Kötü yazılmış bir rapor sorgusu
- Büyük bir JOIN + ORDER BY
- Yanlış
work_memkombinasyonu
–Disk dolabilir
-IO latency fırlar
-Diğer sağlıklı sorgular da yavaşlar
Bu ayarı canlı sistemlerde:
- Özellikle raporlama
- BI
- Ad-hoc sorgu yazılan sistemlerde
sigorta gibi kullanırım.
“Bu sorgu hata alsın ama sunucu ölmesin.”
Kernel Kaynakları – PostgreSQL’in OS ile Sınırları
max_files_per_process – “Dosya Açma Limiti” Tuzağı
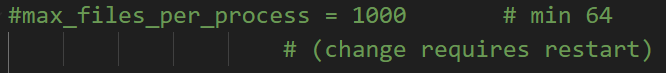
Bu ayar PostgreSQL’in tek bir backend process için:
- Aynı anda kaç dosya açabileceğini
belirler.
Dosya derken:
- Table
- Index
- TOAST
- FSM
- VM
hepsi dahil.
Gerçek hayatta ne zaman patlar?
- Çok fazla index varsa
- Çok partition’lı tablolar varsa
- Büyük join’lerde çok relation açılıyorsa
Bu ayar düşük kalırsa:
- “too many open files” hataları
- Anlaması zor, rastgele görünen sorunlar
oluşur.
Ama şuna dikkat:
Bu ayar PostgreSQL tarafı
OS tarafında daulimituyumlu olmalı
Yani PostgreSQL’i artırıp, Linux tarafını artırmazsan hiçbir şey değişmez.
Ve evet, bu ayar restart gerektirir.
“Canlıda biraz yükseltelim” ayarı değildir.
Asynchronous Behavior – PostgreSQL IO’yu Nasıl Akıllandırır?
effective_io_concurrency – PostgreSQL’e “Önden Oku” Demek
effective_io_concurrency = 0
Bu ayar PostgreSQL’e şunu söyler:
“Diskten veri okurken, aynı anda birden fazla IO isteği gönderebilirsin.”
Özellikle:
- SSD
- NVMe
- SAN
kullanan sistemlerde çok etkilidir.
0 demek:
“Bu özelliği kapat.”
Bu genelde:
- HDD
- yavaş disk
ortamları için güvenlidir.
Ama modern disklerde bu ayar:
- Bitmap scan
- Index scan
- Sequential scan
performansını ciddi şekilde etkiler.
Yanlış ayarlanırsa ne olur?
- Disk IO queue dolar
- Latency artar
- “Disk var ama performans yok” durumu oluşur
Paralellik Ayarları – Güç Sandığın Şey Silaha Dönüşebilir
Paralel sorgular PostgreSQL’in en yanlış kullanılan özelliklerinden biridir.
Çünkü herkes şunu düşünür:
“Daha fazla worker = daha hızlı sorgu”
Ama kimse şunu düşünmez:
“Daha fazla worker = daha fazla RAM + daha fazla IO + daha fazla CPU context switch”
max_worker_processes – PostgreSQL’in Genel İşçi Havuzu

Bu ayar:
- Parallel query
- Logical replication
- Background worker’lar
için kullanılan üst sınırdır.
Bu sayıyı artırdığında:
- Daha fazla parallel işlem çalışabilir
- Ama her worker:
- Bellek tüketir
- CPU scheduling’e girer
Bu ayar restart gerektirir.
max_parallel_workers – Aynı Anda Kaç Worker Çalışabilir?

Bu, max_worker_processes içinden ayrılan paralel worker sayısıdır.
Gerçek hayatta:
- CPU core sayısından büyük ayarlamak
- RAM’i hesaba katmamak
çok sık yapılan hatadır.
Sonuç?
- CPU %100
- Load average uçmuş
- Ama sorgular hâlâ yavaş
max_parallel_workers_per_gather – Tek Sorgu Kaç Kişiyle Çalışır?

Bu ayar çok kritik.
Bir sorgu için:
- Kaç paralel worker kullanılabileceğini
belirler.
Şunu düşün:
- Aynı anda 10 kullanıcı
- Her biri 2 worker açıyor
20 worker sadece query için
Yanlış ayarlandığında:
- Paralellik kazanç değil
- Sistem genelinde darboğaz olur
Burayı Kapatırken Şunu Net Söyleyeyim
Disk, kernel ve paralellik ayarları:
- “Biraz kurcalayalım” alanı değildir
- Sistem mimarisiyle birlikte düşünülür
Yanlış bir paralellik ayarı:
- Doğru bellek ayarlarını boşa çıkarır
Yanlış bir disk ayarı: - En iyi sorguyu bile yavaşlatır
Bu yüzden ben bu ayarlara bakarken hep şu soruyu sorarım:
“Bu sunucuda aynı anda kaç kişi, ne tür sorgular çalıştırıyor?”
Cevap net değilse, ayara dokunmam.
PostgreSQL’i Okumak Değil , Anlamak adlı serimizin ikinci bölümünün sonuna gelmiş olduk.
Bu bölümde sağlam bir temel attın ve config dosyalarının önemini artık biliyorsun , sonraki bölümlerle kendini geliştirmeye devam edebilirsin.
Yazan : Nedim Akıl ( https://www.linkedin.com/in/ndmakl/ )